1. O que é MLOps?
2. Como funciona o MLOps na prática
3. Benefícios e vantagens do MLOps
4. Desafios e limitações do MLOps
5. Qual a diferença entre MLOps e DevOps?
6. MLOps, LLMOps e AgentOps: o que muda com a IA generativa
7. Conclusão
Boa parte dos projetos de inteligência artificial morre no caminho entre o notebook do cientista de dados e o ambiente de produção. O modelo acerta as previsões no conjunto de teste, convence na apresentação interna e nunca passa a operar dentro de um processo real da empresa. MLOps é a disciplina que trata justamente desse intervalo, entre o modelo pronto e o modelo em operação, com responsável definido e histórico de versões.
A sigla significa machine learning operations e descreve as práticas que colocam modelos de machine learning em produção e os mantêm funcionando ao longo do tempo.
O ponto de partida deste artigo é que MLOps é menos uma escolha de ferramenta e mais uma decisão de organização, porque o gargalo quase nunca está no algoritmo.
O que vem a seguir cobre a definição, o funcionamento, os ganhos reais, os limites da prática e a diferença entre MLOps e as rotinas que surgiram depois dos modelos de linguagem. A leitura serve tanto para quem ainda não tem nenhum modelo em produção quanto para quem já tem alguns e começou a sentir o custo de mantê-los.
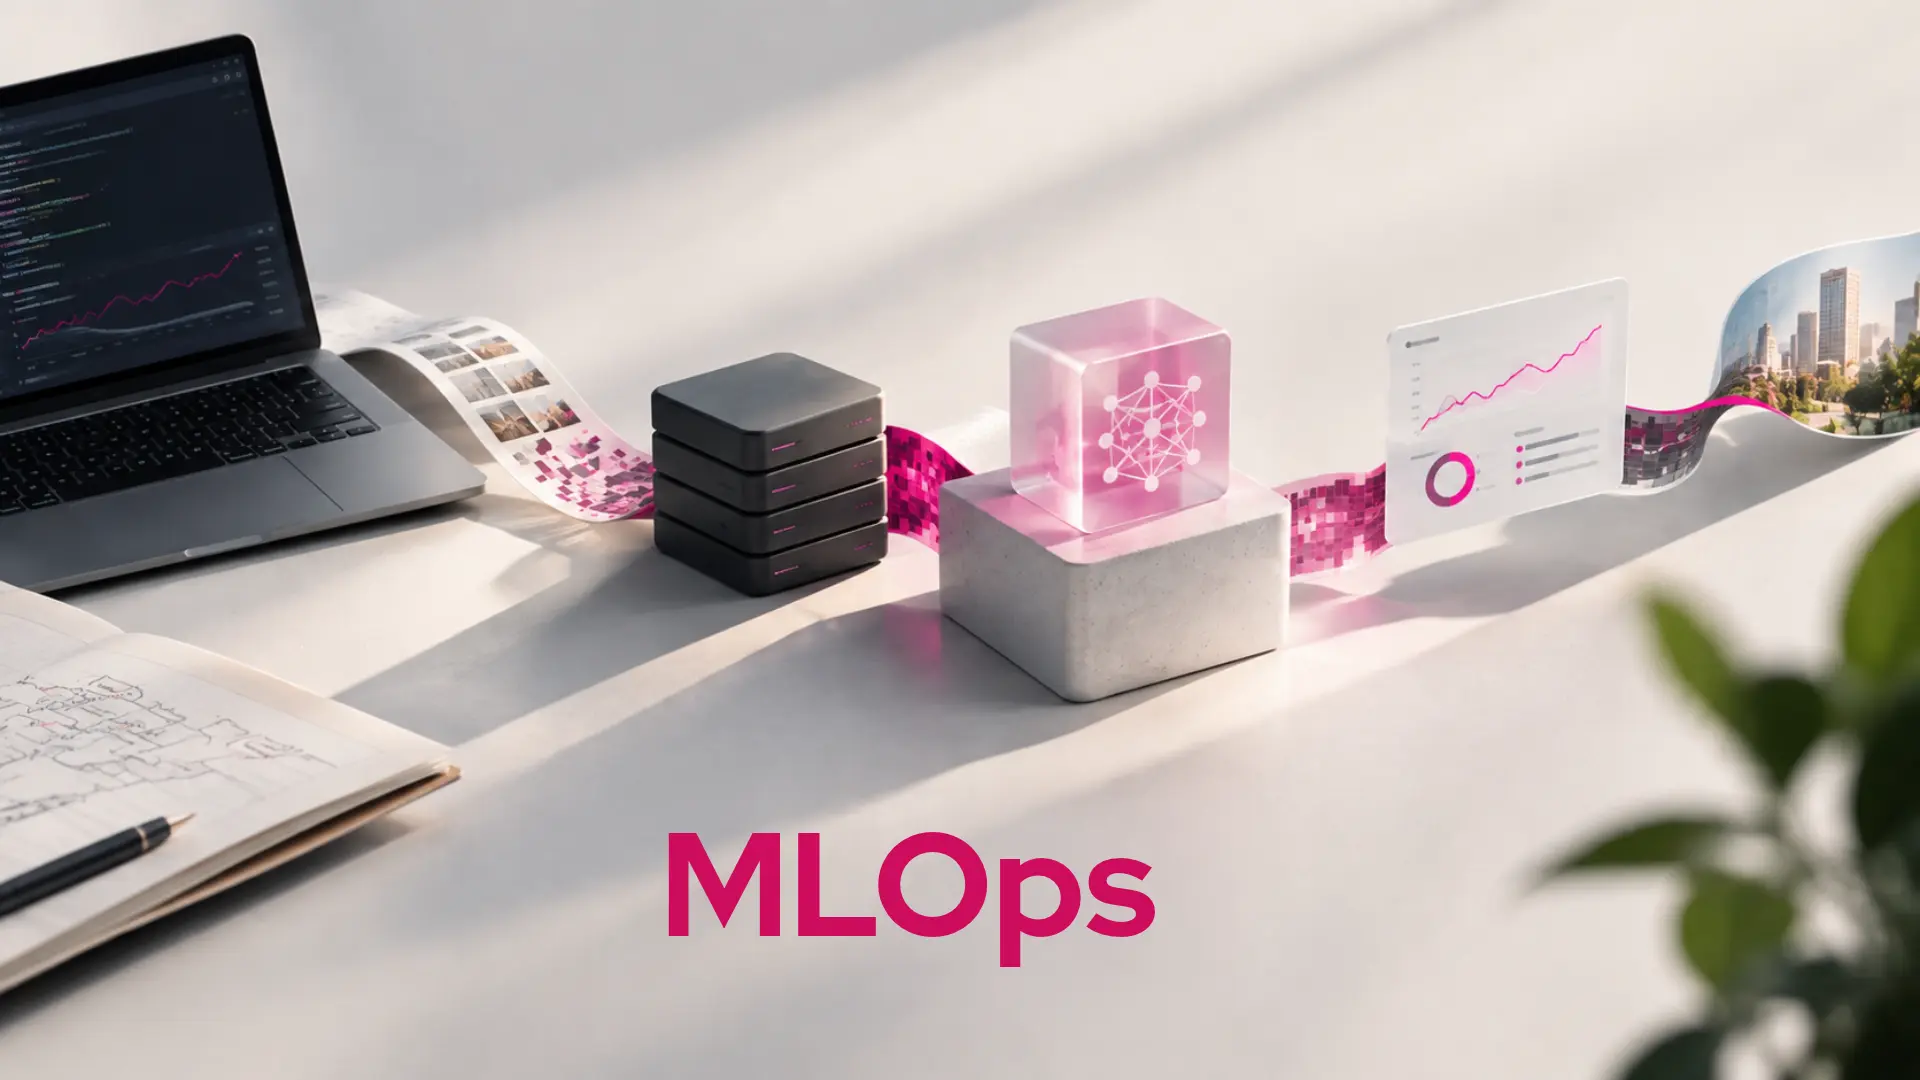
MLOps, ou machine learning operations, é o conjunto de práticas que automatiza e padroniza o ciclo de vida de modelos de machine learning, do preparo dos dados ao monitoramento em produção. Ele combina engenharia de dados, ciência de dados e rotinas de DevOps para que um modelo possa ser treinado, versionado, implantado, monitorado e retreinado de forma repetível.
Times diferentes conseguem operá-lo sem depender da memória de quem o construiu. A diferença em relação ao desenvolvimento tradicional de software está no objeto: além do código, MLOps versiona e testa dados e modelos, que perdem qualidade com o tempo mesmo quando ninguém altera uma linha do sistema.
O termo apareceu em 2015, no artigo Hidden Technical Debt in Machine Learning Systems, escrito por pesquisadores do Google e apresentado no NeurIPS.
O trabalho mostrava algo que continua verdadeiro: o código do modelo ocupa uma fatia pequena de um sistema de machine learning em operação, e a maior parte do esforço vai para coleta de dados, configuração, infraestrutura de serviço e monitoramento.
Machine learning e MLOps são conceitos vizinhos e se confundem com frequência, inclusive em descrição de vaga. Machine learning é a construção do modelo, com escolha de algoritmo, treinamento e avaliação de acurácia. MLOps é tudo o que acontece depois que o modelo existe: como ele chega ao ambiente produtivo, quem responde quando ele erra, com que frequência é retreinado e como a empresa prova, meses depois, qual versão gerou qual decisão.
Não existe um desenho único de MLOps, e desconfie de quem apresenta um. O que existe é um ciclo com etapas reconhecíveis, graus variados de automação e um princípio comum: nada que precise ser repetido deveria depender de execução manual.
Quem vem de desenvolvimento de software já conhece integração e entrega contínuas, o CI/CD, e em MLOps os dois termos ganham escopo maior: a integração contínua testa e valida também os dados e o modelo, não apenas o código, e a entrega contínua publica um pipeline de treinamento, não um pacote pronto.
A esses dois se somam outros dois. O treinamento contínuo retreina o modelo automaticamente quando novos dados chegam ou quando o desempenho cai abaixo de um limite definido.
O monitoramento contínuo acompanha dados de entrada e métricas de negócio, e é o que permite descobrir um problema antes do cliente descobrir.
A literatura técnica costuma organizar a adoção em três níveis. No nível 0, tudo é manual: o cientista de dados entrega um modelo treinado, a engenharia implanta como consegue, o retreinamento acontece poucas vezes por ano e o monitoramento ativo não existe.
No nível 1, o pipeline de treinamento está automatizado e o modelo se atualiza com dados novos sem intervenção. No nível 2, o próprio pipeline entra em CI/CD, com orquestrador e registro de modelos, e a empresa consegue retreinar e reimplantar em horas.
A maioria das empresas brasileiras que já contratou ciência de dados está no nível 0, com casos pontuais no nível 1. Isso não é um diagnóstico de atraso: chegar ao nível 2 custa caro e só compensa em operações com muitos modelos e retreinamento frequente.
O erro mais comum não é ficar no nível 0, é ficar no nível 0 sem saber, porque alguém disse que o modelo está em produção quando ele roda em um script agendado que ninguém mais entende.
Os ganhos de MLOps aparecem em duas frentes: velocidade para colocar um modelo no ar e capacidade de mantê-lo confiável depois. A segunda é a que raramente entra na conta do projeto inicial, e é a que mais pesa no custo total.
Nenhum desses benefícios se materializa a partir do primeiro modelo, porque todos dependem de escala e de repetição. Por isso MLOps compensa mais para quem mantém uma carteira de modelos em operação do que para quem tem um piloto isolado.
Há duas perguntas diferentes escondidas aqui, e os dois lados importam para decidir. A primeira é o que custa não ter MLOps. A segunda é o que custa ter.
Mais da metade dos projetos de IA em fase de prova de conceito nunca chega a produção, 54% segundo estudo global de maturidade em IA conduzido pela IDC em 2026.
O mesmo levantamento aponta a prontidão e a qualidade dos dados como principal causa de atraso, à frente da escassez de talentos e das limitações de desempenho tecnológico.
A conversão de piloto em operação é ainda mais baixa em pesquisas anteriores do mesmo instituto: para cada 33 provas de conceito iniciadas, apenas quatro chegavam a implantação ampla, em levantamento da IDC com a Lenovo publicado em 2025. Os autores atribuem o resultado ao baixo grau de preparo organizacional em dados, processos e infraestrutura, não à qualidade dos modelos.
O efeito prático disso é conhecido por qualquer time que já operou modelo sem estrutura. Um detector de fraude treinado com padrões do ano anterior segue reportando confiança alta enquanto erra em modalidades novas de golpe.
Em outro caso comum, uma transformação de dados feita no treinamento e esquecida na produção entrega entradas em formato diferente do esperado. O erro aparece só no resultado do trimestre.
A comparação só faz sentido com um critério explícito, e o critério aqui é o tipo de artefato que cada prática gerencia. DevOps administra código, que é determinístico: dado o mesmo input, o sistema responde igual hoje e em seis meses. MLOps administra código, dados e modelo ao mesmo tempo, e os dois últimos mudam sem que ninguém os altere, acompanhando as mudanças do mundo que descrevem.
Essa diferença aparece no desenho dos testes. Em DevOps, o teste verifica se a função retorna o resultado esperado. Em MLOps, o teste também precisa validar esquema de dados, distribuição estatística das entradas e qualidade do modelo treinado, três coisas que passam sem erro de compilação e ainda assim quebram a operação.
Há um segundo nível nessa discussão, que é de cultura. DevOps se consolidou com times de desenvolvimento e operações negociando responsabilidade sobre um artefato comum.
MLOps precisa fazer isso com um time a mais na mesa, o de ciência de dados, cujo trabalho é experimental por natureza e resiste mal a padronização. Na prática, é comum que o obstáculo de adoção seja esse acordo, não a ferramenta.
A maioria do conteúdo sobre MLOps foi escrita antes de os modelos de linguagem entrarem no orçamento das empresas. Isso deixa uma pergunta em aberto para quem decide agora: vale investir em MLOps se o próximo projeto da casa é IA generativa?
A resposta depende de qual camada da prática se considera, e vale separar o que se aproveita do que perde função.
LLMOps é a adaptação dessas práticas para modelos de linguagem, e AgentOps estende a lógica para agentes de IA, que executam sequências de ações com ferramentas externas.
Em todos os casos permanecem os mesmos pilares: versionamento, observabilidade, controle de acesso, aprovação formal antes do go-live e capacidade de reverter uma versão que piorou.
O que muda é o objeto de controle. Não se retreina um modelo de fronteira a cada semana, então o ciclo de treinamento contínuo perde centralidade. O esforço migra para o que de fato varia: prompts, contexto recuperado, escolha de modelo, ferramentas conectadas e limites de comportamento.
A avaliação também muda de natureza, porque não existe acurácia única para uma resposta em texto livre. O time passa a manter conjuntos de teste próprios, com critérios de qualidade definidos pelo negócio.
Entra ainda uma variável que MLOps clássico não tinha. Cada resposta gerada tem custo direto de inferência, então escolha de modelo por tarefa, tamanho de contexto e cache passam a ser monitorados como métrica de operação, ao lado de latência e taxa de erro.
Para quem está no nível 0 e vai começar pela IA generativa, a ordem tradicional se inverte. Em vez de montar a esteira completa de treinamento, comece pela observabilidade e pelo controle de versão do que o sistema faz em produção, porque esse é o pedaço que serve para modelo preditivo, modelo de linguagem e agente sem retrabalho.
Em síntese, MLOps resolve um problema de operação, não de modelagem. O que impede a maioria dos projetos de IA de gerar retorno não é a falta de um algoritmo melhor.
É a ausência de um caminho repetível entre o experimento aprovado e o processo que roda todo dia, com dado real, responsável definido e histórico auditável.
Em resumo, três elementos explicam por que essa disciplina virou pré-requisito. Dados mudam continuamente e modelos degradam por consequência, o que faz do monitoramento uma condição de operação e não um refinamento.
A exigência regulatória cresceu e passou a demandar rastreabilidade de decisão automatizada. A isso se soma a quantidade de modelos por empresa, que cresceu até o ponto em que controle manual de versões e de desempenho deixou de ser viável.
O desdobramento para os próximos anos é a convergência entre MLOps, LLMOps e AgentOps em uma única função de operação de IA. Empresas que já tinham versionamento e observabilidade para modelos preditivos estão adaptando essa base para agentes a custo baixo, enquanto as demais montam tudo do zero, agora com mais pressa e mais sistemas para cobrir ao mesmo tempo.
O custo de não agir raramente aparece como incidente, e é isso que dificulta a priorização. Modelo sem monitoramento não cai nem dispara alarme, apenas passa a errar mais, e a conta chega como meta não batida, fraude não detectada ou cliente perdido, sem que ninguém conecte o resultado à decisão técnica tomada meses antes.
A pergunta pendente para quem lidera essa área não é se vale adotar MLOps, mas em que nível de maturidade parar, com que time e em qual ordem.
Operacionalizar modelos em produção exige arquitetura que converse com sistemas legados, governança que sustente o uso em processo crítico e experiência de go-live que não se aprende em piloto. Conheça o AI Factory do Distrito e veja como levar seus modelos do caso de uso à operação.