1. O que é deep learning?
2. Como funciona o aprendizado profundo na prática
3. Deep learning, machine learning e redes neurais: as diferenças
4. Principais arquiteturas de deep learning
5. Deep learning e IA generativa
6. Onde o deep learning é aplicado hoje
7. Vantagens do deep learning
8. Desafios do aprendizado profundo
9. Por que o deep learning importa para as empresas agora
10. Perguntas frequentes sobre deep learning
11. Conclusão
Dois dos quatro Prêmios Nobel concedidos em 2024, nas categorias de Física e Química, reconheceram pesquisadores que atuam com redes neurais artificiais e predição de estruturas de proteínas, conforme aponta o AI Index Report 2025, da Stanford HAI. O prêmio marca um ponto de virada simbólico: a técnica que sustenta esses avanços, o deep learning, deixou de ser um ramo específico do machine learning para explicar boa parte do que hoje se chama de inteligência artificial.
Para quem lidera decisões de tecnologia dentro de uma empresa, entender deep learning deixou de ser opcional. A técnica está por trás de sistemas de reconhecimento de imagem, modelos de linguagem e ferramentas de previsão que já orientam decisões operacionais em setores como saúde, finanças e indústria.
Este artigo explica o que é deep learning, como a tecnologia funciona na prática e em que situações ela realmente faz diferença para o negócio.
Deep learning, ou aprendizado profundo, é uma subárea do machine learning baseada em redes neurais artificiais organizadas em múltiplas camadas. Diferente dos algoritmos tradicionais de aprendizado de máquina, que dependem de variáveis selecionadas manualmente por especialistas, os modelos de deep learning aprendem a extrair padrões diretamente dos dados brutos, sem intervenção humana na etapa de seleção de características.
Essa capacidade de processar informação de forma hierárquica, camada após camada, é o que permite a esses sistemas reconhecer imagens, interpretar linguagem natural e prever comportamentos complexos com um nível de precisão que técnicas mais simples raramente alcançam.
O termo profundo se refere à quantidade de camadas ocultas entre a entrada e a saída da rede neural, geralmente mais de três, podendo chegar a centenas ou milhares em modelos mais avançados. Cada camada adicional permite que o modelo capture representações mais abstratas dos dados: uma rede treinada para reconhecer rostos, por exemplo, pode identificar bordas nas primeiras camadas, formas nas camadas intermediárias e características faciais completas nas camadas finais.
O funcionamento do deep learning combina três elementos: uma arquitetura de camadas que transforma os dados, um mecanismo de aprendizado que corrige os erros do modelo e uma infraestrutura de processamento capaz de sustentar o volume de cálculos envolvido. Entender como essas três partes se encaixam ajuda a avaliar o que um projeto de aprendizado profundo realmente exige.
Uma rede neural de deep learning é organizada em três tipos de camada. A camada de entrada recebe os dados brutos, como os pixels de uma imagem ou o texto de uma frase. As camadas ocultas processam essas informações, ajustando pesos internos a cada rodada de treinamento. A camada de saída entrega o resultado final, seja uma classificação, uma previsão ou um texto gerado.
Cada conexão entre neurônios carrega um peso, um número que amplifica ou reduz a influência daquela ligação sobre a próxima camada. É o ajuste coletivo desses pesos, ao longo do treinamento, que faz o modelo aprender.
Quando se fala em um modelo de linguagem com bilhões de parâmetros, esse número reflete justamente a quantidade de pesos e vieses ajustáveis dentro da rede.
O aprendizado começa com uma comparação. A cada previsão, o modelo mede a distância entre o resultado que produziu e o resultado esperado, usando uma função de perda que quantifica esse erro. Reduzir esse valor de forma consistente é o objetivo de todo o treinamento.
Para saber como corrigir cada peso, a rede usa a retropropagação. O método percorre a rede da saída de volta até a entrada e calcula quanto cada parâmetro contribuiu para o erro final, distribuindo a responsabilidade entre milhões de conexões de uma só vez. Sem ele, ajustar individualmente cada peso de uma rede grande seria inviável na prática.
Com essa informação em mãos, entra o gradiente descendente: o algoritmo que decide em que direção mover cada peso para diminuir a perda. A cada rodada, os parâmetros são atualizados um passo na direção que reduz o erro, e o ciclo se repete milhares ou milhões de vezes até o modelo atingir um nível aceitável de precisão.
Todo esse processo envolve multiplicações de matrizes em escala massiva, repetidas a cada passo do treinamento. As unidades de processamento gráfico (GPUs) executam esse tipo de cálculo em paralelo, o que as tornou o hardware padrão para treinar e operar modelos de aprendizado profundo.
Essa dependência de infraestrutura tem uma implicação direta para o negócio: o custo de treinar modelos do zero é alto, e por isso serviços de computação em nuvem e modelos pré-treinados se tornaram parte central do ecossistema. Para a maioria das empresas, a decisão relevante não é montar um data center de GPUs, mas escolher entre treinar, ajustar um modelo existente ou consumir a capacidade via nuvem.
Três termos aparecem juntos em quase toda discussão sobre o tema, e a confusão entre eles atrapalha decisões práticas. Deep learning, machine learning e redes neurais não são sinônimos: cada um ocupa um lugar específico na hierarquia da inteligência artificial, e entender essa distinção ajuda times de tecnologia e de negócio a avaliar qual abordagem faz sentido para cada problema.
A diferença entre deep learning e machine learning tradicional está na forma como cada abordagem lida com a extração de características dos dados. Machine learning clássico depende de especialistas humanos para definir quais variáveis o modelo deve considerar, processo conhecido como feature engineering. Deep learning automatiza essa etapa: a própria rede neural aprende quais características são relevantes durante o treinamento, a partir de grandes volumes de dados.
Essa automação tem um custo. Modelos de deep learning exigem volumes de dados e poder computacional muito maiores do que algoritmos tradicionais, como árvores de decisão ou regressão logística. Para tarefas simples, com dados estruturados e volume limitado, o machine learning tradicional costuma ser mais eficiente e mais fácil de interpretar. Para tarefas complexas, como visão computacional ou processamento de linguagem, o aprendizado profundo se torna praticamente indispensável.
Uma dúvida comum é tratar deep learning e redes neurais como a mesma coisa. A rede neural é o modelo matemático de base, inspirado de forma simplificada no funcionamento do cérebro, composto por nós interconectados organizados em camadas. O deep learning é uma aplicação específica desse modelo: o uso de redes com muitas camadas ocultas para aprender representações complexas.
Na prática, toda técnica de deep learning usa redes neurais, mas nem toda rede neural é deep learning. Uma rede rasa, com uma única camada oculta, resolve problemas simples sem entrar no domínio do aprendizado profundo. É a profundidade, ou seja, o empilhamento de várias camadas, que distingue um modelo de deep learning de uma rede neural convencional.
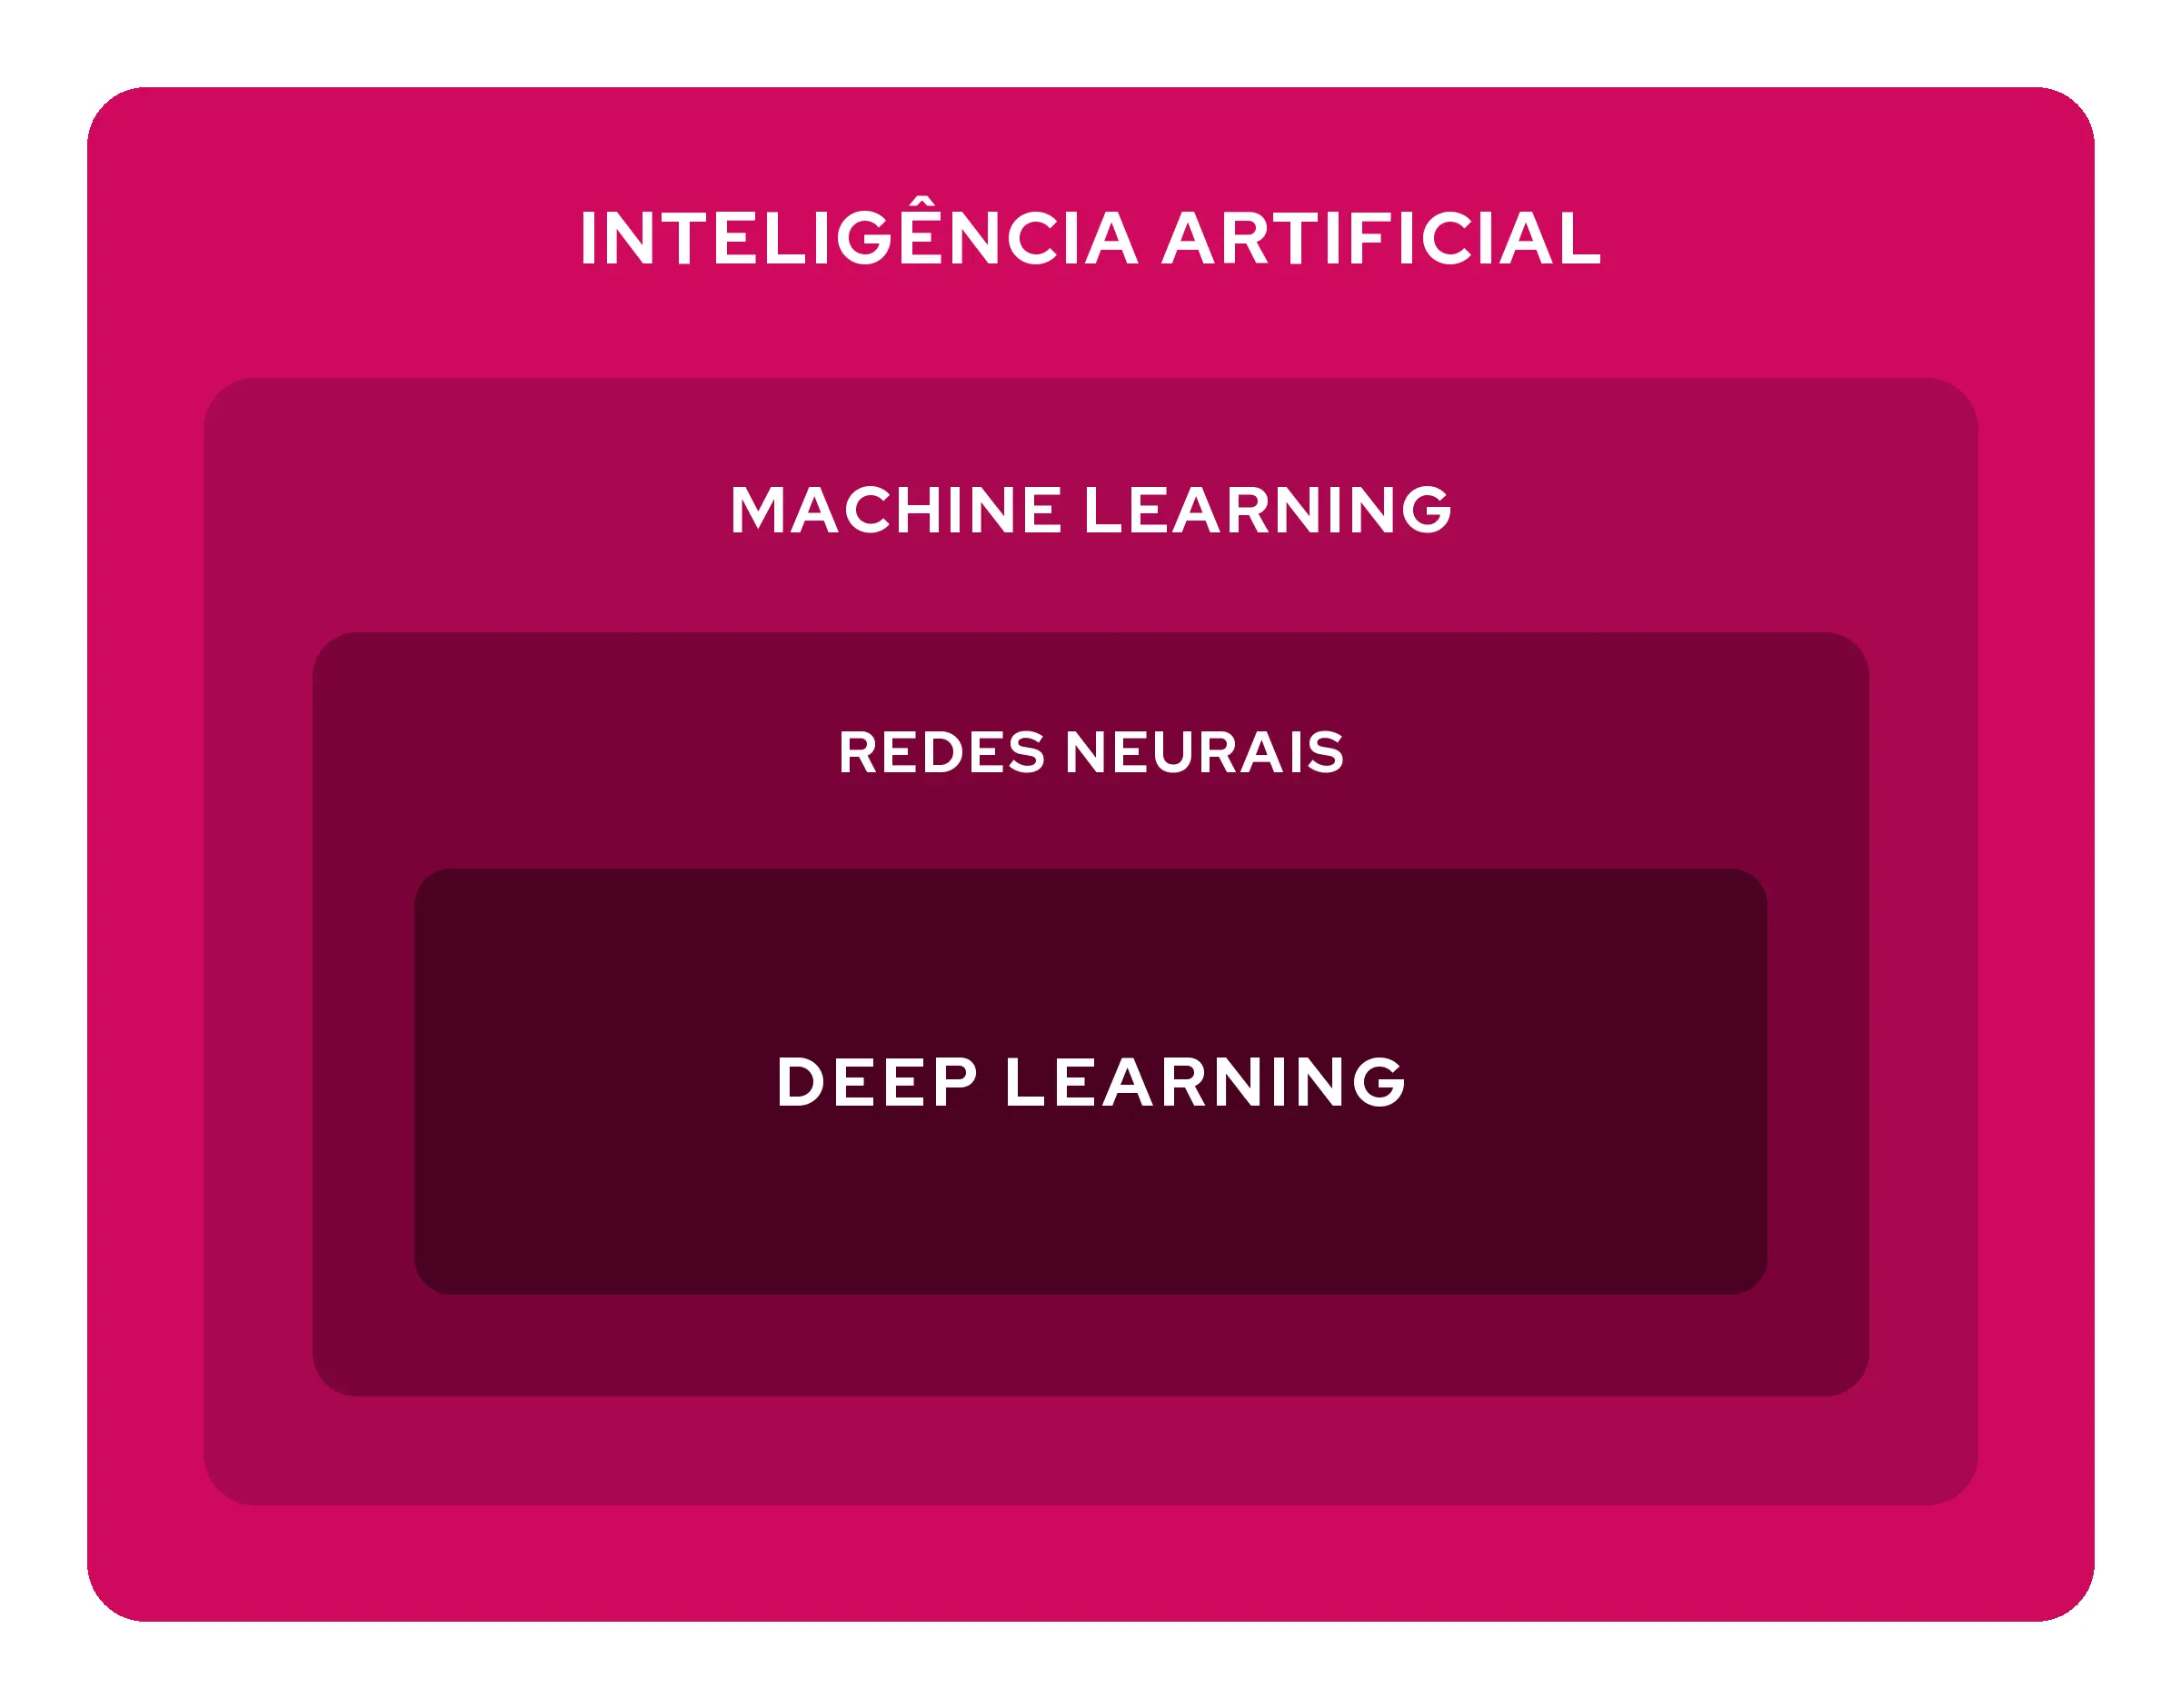
Para situar os quatro termos de uma vez, vale registrar a hierarquia mais ampla que os organiza: o campo da inteligência artificial contém o machine learning, que contém as redes neurais, que quando ganham profundidade dão origem ao deep learning.
Para ilustrar visualmente, podemos nos orientar e entender o deep learning por meio do seguinte esquema:
Não existe uma única forma de rede neural profunda. Ao longo das últimas décadas, diferentes arquiteturas surgiram para resolver limitações específicas umas das outras, cada uma otimizada para um tipo de dado ou tarefa. Conhecer as principais ajuda a entender por que um modelo funciona bem para imagens e outro para texto, e a mapear qual se aplica a cada problema de negócio.
As redes neurais convolucionais são a arquitetura de referência para visão computacional. Elas usam camadas de convolução, que aplicam filtros percorrendo a imagem em busca de padrões locais, como bordas, texturas e formas, preservando a relação espacial entre os pixels.
Essa estrutura resolve um problema prático: processar uma imagem inteira com camadas totalmente conectadas exigiria parâmetros demais e tenderia ao overfitting. As CNNs extraem características progressivamente mais complexas a cada camada, o que as torna eficientes em reconhecimento facial, detecção de objetos e análise de imagens médicas.
As redes neurais recorrentes foram projetadas para dados sequenciais, como texto, áudio e séries temporais. Diferente das redes convencionais, elas operam em loop: a saída de uma etapa alimenta o cálculo da etapa seguinte, criando uma espécie de memória interna que preserva o contexto e a ordem da sequência.
Na forma tradicional, essas redes têm dificuldade em capturar dependências de longo prazo. Variantes como as LSTM (Long Short-Term Memory) e as GRU (Gated Recurrent Units) foram criadas justamente para mitigar esse limite e sustentar sequências mais longas.
Os transformers são a arquitetura que abriu a era atual da IA generativa. Sua peça central é o mecanismo de atenção, que permite ao modelo avaliar quais partes de uma sequência são mais relevantes para interpretar cada elemento, considerando o contexto entre palavras distantes umas das outras.
Ao dispensar o processamento sequencial das RNNs, os transformers ganharam paralelismo e escala, o que viabilizou o treinamento de modelos muito maiores. É essa arquitetura que sustenta os modelos de linguagem por trás de ferramentas de geração de texto e assistentes conversacionais.
As redes adversárias generativas combinam duas redes que competem entre si. Uma rede geradora cria exemplos artificiais, e uma rede discriminadora tenta distinguir o que é real do que foi gerado. As duas se aprimoram em conjunto até que as amostras sintéticas fiquem difíceis de diferenciar das reais.
Essa dinâmica torna as GANs capazes de gerar imagens, áudio e vídeo realistas, com aplicações que vão de restauração de dados corrompidos até a criação de conteúdo sintético, incluindo os deepfakes.
Os modelos de difusão são hoje a base de boa parte da geração de imagens de alta qualidade. Eles aprendem adicionando ruído a uma imagem em etapas sucessivas até restar apenas ruído aleatório, e depois treinando uma rede para reverter esse processo, reconstruindo dados estruturados a partir do ruído.
Uma vez treinado, o modelo gera novas amostras partindo de ruído puro e removendo-o de forma guiada, muitas vezes condicionado por um texto de entrada. Essa combinação de qualidade e controle explica sua adoção em ferramentas de geração de imagem a partir de descrições.
Cada uma dessas arquiteturas é implementada com frameworks de código aberto que padronizam o desenvolvimento. PyTorch, TensorFlow e Keras concentram a maior parte dos projetos, e a biblioteca Hugging Face Transformers se tornou referência para trabalhar com modelos baseados em transformers.
A onda de IA generativa que redefiniu o mercado a partir de 2022 é, na base, uma aplicação de deep learning. Os modelos que geram texto, imagem e código são redes neurais profundas treinadas em escala massiva, e a arquitetura transformer foi o que tornou esse salto possível.
O elo técnico entre as duas coisas passa por uma mudança na forma de treinar. Em vez de depender de dados rotulados por especialistas, os modelos generativos usam aprendizado autossupervisionado: aprendem padrões a partir de grandes volumes de dados não rotulados, o que viabilizou os foundation models que sustentam a IA generativa atual.
Para o negócio, essa conexão tem uma consequência prática: adotar IA generativa é adotar deep learning, com as mesmas exigências de dados, infraestrutura e governança. Isso ajuda a explicar por que a adoção corporativa disparou, mas o valor ainda se concentra em poucas empresas. Embora 88% das organizações já usem IA em pelo menos uma função e 79% usem IA generativa (McKinsey, State of AI, 2025), a maioria segue presa em pilotos, sem escalar a tecnologia para produção.
O aprendizado profundo já opera em segundo plano em produtos e serviços que boa parte das empresas usa diariamente. Alguns exemplos ilustram a amplitude dessas aplicações:
Em comum, essas aplicações lidam com dados não estruturados, como imagem, texto, áudio ou padrões comportamentais complexos, exatamente o tipo de informação em que o deep learning supera abordagens mais simples de machine learning. No Brasil, esse padrão já aparece em operações concretas: bancos e fintechs usam aprendizado profundo em antifraude e análise de crédito, e a indústria aplica visão computacional para inspeção de equipamentos e manutenção preditiva.
As vantagens do aprendizado profundo explicam por que a técnica se tornou padrão para problemas complexos, apesar do custo. As principais são:
Apesar dos resultados, o deep learning carrega limitações que afetam diretamente decisões de negócio. A mais discutida é a falta de interpretabilidade: modelos com múltiplas camadas ocultas funcionam como caixas-pretas, produzindo respostas sem explicitar quais fatores levaram àquela conclusão. Essa característica dificulta auditorias internas e o cumprimento de regulamentações que exigem explicabilidade, como normas setoriais de crédito e saúde.
Outro desafio é o custo. Treinar modelos de deep learning exige infraestrutura de processamento de alto desempenho e volumes de dados que nem toda empresa tem disponível ou consegue organizar com qualidade suficiente. Segundo levantamento da BCG (2024), 74% das empresas que investiram em projetos de inteligência artificial ainda não conseguiram demonstrar valor tangível a partir desses investimentos, um problema que se agrava quando o projeto depende de dados que a empresa não possui em volume ou qualidade adequados.
Há também o risco de overfitting: quando o modelo memoriza os exemplos de treinamento em vez de aprender padrões gerais, ele acerta nos dados conhecidos e falha diante de dados novos. Técnicas de regularização e validação ajudam a controlar esse comportamento, mas ele exige atenção constante durante o desenvolvimento.
Por fim, há o problema da imprevisibilidade: pequenas variações na entrada, como ruído em uma imagem ou uma frase ambígua, podem gerar respostas inesperadas. Isso torna a validação de modelos de deep learning mais complexa do que a de sistemas baseados em regras fixas, e reforça a necessidade de testes rigorosos antes de colocar esses modelos em produção, especialmente em aplicações críticas como diagnóstico médico ou veículos autônomos.
O reconhecimento do deep learning em prêmios científicos de peso, como os Nobel de Física e Química de 2024, concedidos a pesquisadores de redes neurais e de predição de proteínas, segundo o AI Index Report 2025 da Stanford HAI (2025), reflete uma mudança de status da tecnologia: deixou de ser uma promessa de laboratório para se tornar infraestrutura crítica de decisão em setores inteiros.
Para empresas, isso significa que decisões sobre adotar ou não deep learning deixam de ser uma questão de inovação para se tornar uma questão de competitividade direta. Organizações que já estruturaram times e processos para lidar com dados não estruturados, como imagem, texto e áudio, têm hoje uma vantagem que será cada vez mais difícil de recuperar à medida que a tecnologia amadurece e se torna padrão de mercado.
Deep learning é o mesmo que inteligência artificial?
Não. A inteligência artificial é o campo mais amplo, que busca fazer máquinas executarem tarefas que exigiriam inteligência humana. O deep learning é uma técnica específica dentro do machine learning, que por sua vez é uma subárea da IA. Todo deep learning é inteligência artificial, mas a maior parte da IA não é deep learning.
Qual a diferença entre deep learning e machine learning?
No machine learning tradicional, especialistas definem manualmente quais variáveis o modelo deve considerar. No deep learning, a própria rede neural aprende quais características são relevantes a partir dos dados brutos, sem essa seleção manual. A contrapartida é a exigência de mais dados e mais poder computacional.
Deep learning precisa de muitos dados para funcionar?
Em geral, sim. Modelos de aprendizado profundo dependem de grandes volumes de dados para aprender padrões confiáveis, e a qualidade desses dados pesa tanto quanto a quantidade. Para problemas com poucos dados ou dados estruturados simples, o machine learning tradicional costuma entregar melhor resultado com menos esforço.
Deep learning substitui o machine learning tradicional?
Não necessariamente. Para tarefas complexas com dados não estruturados, como visão computacional e linguagem, o deep learning é a melhor escolha. Para problemas mais simples, com dados tabulares e volume limitado, o machine learning tradicional é mais eficiente, mais barato e mais fácil de interpretar.
Por que o deep learning é chamado de caixa-preta?
Porque a decisão de um modelo com muitas camadas ocultas emerge do ajuste de milhões de parâmetros, sem uma explicação intuitiva de quais fatores levaram a cada resultado. Essa baixa interpretabilidade é um dos principais desafios da técnica em setores regulados, como crédito e saúde.
Deep learning é, hoje, a tecnologia que sustenta boa parte dos avanços mais visíveis da inteligência artificial, da geração de texto ao diagnóstico por imagem. Sua capacidade de aprender padrões complexos diretamente dos dados, sem depender de regras definidas manualmente, explica por que a técnica se tornou a referência para problemas que envolvem informação não estruturada.
O desafio, para a maioria das empresas, não é mais entender o que é deep learning, mas decidir onde aplicá-lo com critério. Isso exige avaliar se o problema realmente demanda a complexidade de uma rede neural profunda ou se pode ser resolvido com abordagens mais simples e baratas de machine learning, além de garantir a governança necessária para lidar com um modelo que, por natureza, é menos transparente do que os sistemas tradicionais baseados em regras.
Capacitar lideranças e times de negócio para entender essas escolhas, sem depender exclusivamente da área técnica, é o que diferencia empresas que usam IA com critério das que adotam a tecnologia por impulso. Conheça o Mastering AI do Distrito e prepare sua liderança para tomar decisões informadas sobre onde e como aplicar deep learning na sua operação.